Plik robots.txt: jak go napisać i czego nie blokować
Plik robots.txt mówi robotom, co mogą skanować. Poznaj składnię, przykłady, limity, test w Search Console, boty AI i ustawienia dla WordPressa.
Plik robots.txt to zwykły plik tekstowy w głównym katalogu domeny (na przykład example.pl/robots.txt), w którym informujesz roboty wyszukiwarek, które adresy mogą odwiedzać, a które nie. Reguluje on skanowanie (crawling), a nie indeksowanie, więc nie służy do ukrywania stron w wynikach Google.
W skrócie
- Robots.txt musi leżeć pod adresem
/robots.txtw katalogu głównym domeny, osobno dla każdej domeny i subdomeny. - Podstawowe dyrektywy to
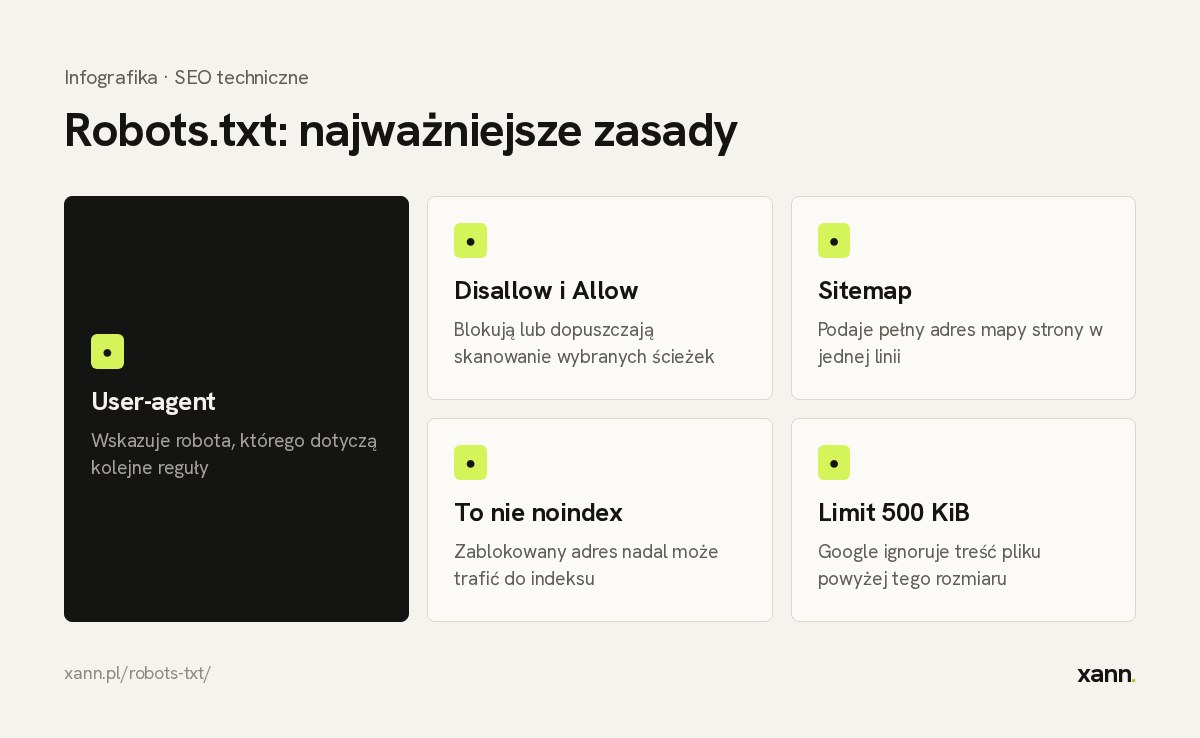
User-agent,Disallow,AllowiSitemap. Google rozumie też symbole*oraz$. - Robots.txt nie jest noindex: zablokowany adres może nadal trafić do indeksu, jeśli prowadzą do niego linki.
- Google przetwarza maksymalnie 500 KiB pliku, a treść powyżej tego limitu jest ignorowana.
- Nie blokuj plików CSS i JavaScript potrzebnych do wyświetlenia strony.
- Stan pliku sprawdzisz w Search Console w raporcie robots.txt (Ustawienia).
Do czego służy plik robots.txt?
Robots.txt służy do zarządzania ruchem robotów na stronie: pozwala odciąć je od sekcji, które nie mają wartości dla wyszukiwarki, takich jak koszyk, wyniki wewnętrznej wyszukiwarki czy panel logowania. Dzięki temu robot nie marnuje czasu na zbędne adresy, a serwer jest mniej obciążony.
To element szerszego tematu, który opisujemy w przewodniku po SEO technicznym. Przy małych stronach robots.txt rzadko ma duży wpływ, ale błąd w nim potrafi zablokować całą witrynę. Zdarza się to najczęściej po wdrożeniu nowej strony, kiedy zostaje zapis z wersji testowej.
Plik jest zaleceniem, którego trzymają się uczciwe roboty, takie jak Googlebot czy Bingbot. Nie jest zabezpieczeniem. Złośliwy skrypt może go zignorować, a sam plik jest publiczny, więc nie umieszczaj w nim adresów, o których nie chcesz, aby ktoś wiedział.
Jak wygląda składnia robots.txt?
Plik składa się z grup reguł. Każda grupa zaczyna się od linii User-agent, która mówi, do którego robota odnoszą się kolejne linie Disallow i Allow.
User-agent: *
Disallow: /koszyk/
Disallow: /wyszukiwanie/
Allow: /wyszukiwanie/pomoc/

User-agent: Googlebot-Image
Disallow: /prywatne-zdjecia/

Sitemap: https://example.pl/sitemap_index.xml
User-agent
Ta linia wskazuje robota. Gwiazdka (*) oznacza wszystkie roboty, a konkretna nazwa, na przykład Googlebot, odnosi się tylko do niego. Robot stosuje się do najbardziej dopasowanej do siebie grupy, a nie do wszystkich naraz, więc reguły z grupy * nie są dodawane do grupy dla Googlebota.
Disallow i Allow
Disallow zabrania skanowania adresów zaczynających się od podanej ścieżki, a Allow pozwala na wyjątki. Pusty Disallow: oznacza brak ograniczeń. Gdy reguły się nakładają, Google stosuje tę bardziej szczegółową, czyli z dłuższą ścieżką. W przykładzie powyżej cała sekcja /wyszukiwanie/ jest zablokowana, ale /wyszukiwanie/pomoc/ pozostaje dostępna.
Uwaga na jeden znak: Disallow: / blokuje całą stronę, a Disallow: bez niczego nie blokuje nic. Różnica to jedna kreska, a skutki są odwrotne.
Sitemap
Linia Sitemap podaje pełny adres mapy strony. Możesz dodać kilka takich linii i nie zależą one od grup User-agent. Więcej o samych mapach w artykule o mapie strony.
Symbole wieloznaczne
Google obsługuje dwa znaki specjalne: * zastępuje dowolny ciąg znaków, a $ oznacza koniec adresu.
User-agent: *
# blokuje adresy z parametrem sortowania
Disallow: /*?sort=
# blokuje wszystkie pliki PDF
Disallow: /*.pdf$
# komentarze zaczynają się od hasha
Reguły rozróżniają wielkość liter w ścieżkach, więc /Koszyk/ i /koszyk/ to różne adresy. Nazwy dyrektyw są natomiast niewrażliwe na wielkość liter.
Czego nie blokować w robots.txt?
Nie blokuj zasobów, które są potrzebne do wyświetlenia strony, przede wszystkim plików CSS, JavaScript i obrazów. Google renderuje strony podobnie jak przeglądarka i jeśli nie ma dostępu do stylów i skryptów, może źle ocenić układ, treść oraz wygodę korzystania ze strony na telefonie.
- CSS i JS: zablokowany skrypt, który buduje treść, oznacza, że Google może jej nie zobaczyć (więcej w tekście o JavaScript SEO).
- Stron, które mają być w noindex: robot musi je odwiedzić, żeby przeczytać tag noindex.
- Stron z przekierowaniami i canonical: jeśli je zablokujesz, robot nie zobaczy przekierowania ani tagu (patrz canonical).
- Folderu z mediami: w WordPressie to
/wp-content/uploads/.
Rozsądnie jest blokować elementy, które generują tysiące bezwartościowych adresów: wyszukiwarkę wewnętrzną, koszyk, kasę, niektóre filtry i kalendarze. Przy dużych serwisach ma to związek z crawl budgetem.
Typowe błędy w robots.txt
Najczęstszy błąd to pozostawienie blokady Disallow: / po wdrożeniu strony z wersji testowej, przez co cała witryna znika z zainteresowania robotów. Drugi to blokowanie katalogów ze stylami i skryptami, a trzeci to użycie ścieżki z literówką, która nic nie blokuje, mimo że wygląda poprawnie.
- Brak ukośnika:
Disallow: /blogzablokuje też adres/blog-firmowy/, bo reguła dopasowuje początek ścieżki. - Kilka plików: robots.txt w podkatalogu jest ignorowany, a plik na subdomenie nie dotyczy domeny głównej.
- Wersja HTTP i HTTPS: upewnij się, że plik jest dostępny pod docelowym adresem i nie wpada w łańcuch przekierowań.
- Zapomniane reguły: po przebudowie serwisu stare wpisy blokują nowe sekcje. Raz na jakiś czas przejrzyj cały plik.
Dobrą praktyką jest trzymanie pliku w repozytorium razem z kodem strony i opisywanie komentarzami, po co jest każda reguła.
Czy robots.txt to to samo co noindex?
Nie. Robots.txt zabrania robotowi wejścia na stronę, a noindex zabrania pokazywania strony w wynikach. Zablokowany adres może nadal pojawić się w Google bez opisu, jeśli prowadzą do niego linki z innych stron, ponieważ Google zna adres, choć nie widział treści.
Co gorsza, jeśli zablokujesz stronę w robots.txt i dodasz na niej noindex, robot nigdy nie zobaczy tagu, bo nie wejdzie na stronę. Efekt jest odwrotny od zamierzonego. Aby usunąć stronę z wyników, pozwól na jej skanowanie i użyj <meta name="robots" content="noindex"> albo nagłówka X-Robots-Tag. Dyrektywa noindex wpisana do samego robots.txt nie jest przez Google obsługiwana od 1 września 2019 roku.
Rozbieżności między tymi mechanizmami powodują część statusów w raporcie stron, które opisujemy w tekście o statusach indeksowania. Ogólny obraz procesu znajdziesz w artykule o indeksowaniu strony w Google.
Jakie są limity pliku robots.txt?
Google przetwarza maksymalnie 500 KiB (kibibajtów) pliku robots.txt, a treść powyżej tego limitu jest ignorowana. Większość stron jest od tego bardzo daleko, ale przy rozbudowanych serwisach z tysiącami reguł warto je łączyć i skracać za pomocą symboli wieloznacznych.
Inne praktyczne zasady:
- plik musi być zapisany w UTF-8 i dostępny pod adresem
/robots.txt; - obowiązuje tylko dla hosta, protokołu i portu, pod którym leży, więc
blog.example.plpotrzebuje własnego pliku; - gdy serwer zwraca kod 404, Google zakłada brak ograniczeń, a przy błędzie serwera (5xx) na jakiś czas wstrzymuje skanowanie witryny, dlatego pilnuj, aby plik był stabilnie dostępny (zob. błąd 500);
- Google zapamiętuje zawartość pliku zwykle na okres do około doby, więc zmiany nie działają natychmiast.
Jak przetestować robots.txt?
W Google Search Console działa raport robots.txt, który zastąpił dawne narzędzie do testowania tego pliku. Znajdziesz go w sekcji „Ustawienia”. Pokazuje, jakie pliki robots.txt Google znalazł dla Twojej domeny, kiedy ostatnio je pobrał, czy były z tym problemy, i pozwala poprosić o ponowne pobranie pliku w pilnych przypadkach.
Raport nie testuje pojedynczych adresów. Do sprawdzenia konkretnego URL-a użyj narzędzia „Sprawdzanie adresu URL” (pokaże, czy adres jest zablokowany przez robots.txt) albo crawlera, na przykład Screaming Frog. Na pierwszym kroku wystarczy też otworzyć example.pl/robots.txt w przeglądarce i obejrzeć plik oczami człowieka. Podstawy pracy z narzędziem znajdziesz w poradniku po Google Search Console.
Po każdej zmianie, zwłaszcza po wdrożeniu nowej wersji strony, sprawdź plik ręcznie. To jeden z elementów naszej checklisty SEO.
Roboty AI w robots.txt
Robots.txt służy też do zarządzania botami firm AI, które mają własne nazwy User-agent. Możesz na przykład zablokować GPTBot (OpenAI) albo tokeny Google-Extended, nie ruszając ruchu Googlebota. Pamiętaj, że blokada botów AI zmniejsza szanse na to, że treść zostanie użyta lub zacytowana, dlatego to decyzja biznesowa, a nie techniczna.
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Google-Extended to token kontrolny, a nie osobny robot: blokada nie wpływa na pozycje w wyszukiwarce. Nie wszystkie boty stosują się do robots.txt, więc nie jest to gwarancja. Szczegóły, listę botów i uzupełniający plik dla modeli językowych opisujemy w artykule o llms.txt. Szerszy kontekst to widoczność w AI.
Robots.txt w WordPressie
WordPress, jeśli nie ma fizycznego pliku, generuje wirtualny robots.txt. Domyślnie blokuje on katalog /wp-admin/, z wyjątkiem pliku admin-ajax.php. Opcja „Proś wyszukiwarki o nieindeksowanie” w ustawieniach czytania dodaje do strony znacznik noindex, a w zależności od wersji i wtyczek może też zmieniać wirtualny robots.txt, dlatego po uruchomieniu strony sprawdź oba miejsca.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.pl/wp-sitemap.xml
Plik edytuje się przez wtyczki SEO (Yoast SEO, Rank Math) albo wgrywając plik robots.txt do katalogu głównego przez FTP. Fizyczny plik ma pierwszeństwo przed wirtualnym. Nie blokuj /wp-content/ ani /wp-includes/, ponieważ znajdują się tam style, skrypty i obrazy. Po uruchomieniu strony produkcyjnej sprawdź, czy nie została z wersji roboczej linia Disallow: /.
Najczęstsze pytania
Gdzie powinien być plik robots.txt?
W katalogu głównym domeny, pod adresem https://example.pl/robots.txt. Plik umieszczony w podkatalogu nie będzie przez roboty uwzględniany. Każda subdomena potrzebuje własnego pliku.
Czy robots.txt usunie stronę z Google?
Nie. Blokada w robots.txt ogranicza skanowanie, ale adres może zostać w indeksie. Do usunięcia z wyników użyj noindex, odpowiedzi 404/410 albo narzędzia usuwania adresów w Search Console.
Czy mogę zablokować roboty AI w robots.txt?
Tak, dla botów, które szanują ten standard, na przykład GPTBot. Pamiętaj, że to jedynie prośba i nie wszystkie roboty ją respektują, a blokada może zmniejszyć widoczność w odpowiedziach czatów.
Jak duży może być plik robots.txt?
Google przetwarza do 500 KiB, a nadwyżka jest ignorowana. Jeśli zbliżasz się do limitu, skróć reguły symbolami wieloznacznymi i usuń nieaktualne wpisy.
Czy brak robots.txt jest błędem?
Nie jest. Gdy serwer zwraca 404 dla tego adresu, roboty traktują to jako brak ograniczeń. Warto jednak mieć plik, choćby po to, by wskazać mapę strony.
Podsumowanie
Robots.txt jest prosty, ale błąd w nim bywa kosztowny. Trzymaj się trzech zasad: nie blokuj CSS i JS, nie traktuj go jak noindex i testuj po każdej zmianie. Jeśli chcesz, żebyśmy przejrzeli plik oraz resztę ustawień indeksowania w Twoim serwisie, zobacz ofertę SEO technicznego.