JavaScript SEO: jak Google renderuje strony w JS
JavaScript SEO: jak Google skanuje, renderuje i indeksuje strony w JS, czym różnią się CSR, SSR i SSG oraz jak je testować w Search Console i GSC.
JavaScript SEO to dbanie o to, by treść i linki generowane przez skrypty były widoczne dla wyszukiwarek. Google potrafi wykonywać JavaScript: pobiera stronę, kolejkuje ją do renderowania w przeglądarce Chromium i dopiero potem indeksuje wynik. Ten proces jest jednak bardziej złożony i podatny na błędy niż odczyt zwykłego HTML.
W skrócie
- Google przetwarza strony w trzech fazach: skanowanie (pobranie HTML), renderowanie (wykonanie JS) i indeksowanie. Renderowanie może nastąpić z opóźnieniem.
- Najbezpieczniejsze dla SEO są SSR i SSG: ważna treść i linki są od razu w HTML-u odpowiedzi serwera.
- Typowe problemy: linki bez atrybutu href, treść doładowywana po kliknięciu lub przewinięciu, błędy skryptów i zablokowane w robots.txt pliki JS i CSS.
- Do testów służy „Sprawdzanie adresu URL” w Google Search Console oraz test wyników z elementami rozszerzonymi.
- Boty AI zwykle nie wykonują JavaScriptu, więc treść dostępna tylko po renderowaniu może być dla nich niewidoczna. Zachowanie zmienia się z czasem, więc sprawdzaj to u siebie.
Jak Google przetwarza JavaScript?
Google przetwarza strony oparte na JavaScript w trzech etapach: skanowanie, renderowanie i indeksowanie. Opisuje to jego dokumentacja dla deweloperów.
Etap 1: skanowanie
Googlebot pobiera adres i odczytuje surowy HTML oraz nagłówki odpowiedzi. Sprawdza też plik robots.txt, bo jeśli adres jest zablokowany, strona nie zostanie pobrana. Z surowego HTML-a wyciąga linki, którymi dotrze do kolejnych stron. Znaczenie ma tu plik robots.txt, a zasady skanowania w dużych serwisach opisujemy w artykule o crawl budget.
Etap 2: kolejka renderowania
Strony, które wymagają JS, trafiają do kolejki. Renderowanie odbywa się w bezgłowej przeglądarce Chromium, która wykonuje skrypty i buduje końcowy DOM. Czas oczekiwania w kolejce bywa krótki, ale nie ma gwarancji. Google nie ujawnia dokładnych wartości, dlatego nie opieraj kluczowych treści wyłącznie na tym etapie. Renderer przetwarza stronę bez interakcji użytkownika: nie klika, nie wpisuje, nie przewija w taki sposób jak człowiek.
Etap 3: indeksowanie
Po renderowaniu Google analizuje wynikowy HTML (treść, linki, dane strukturalne, meta tagi) i decyduje o indeksowaniu. Linki znalezione po renderowaniu trafiają do dalszego skanowania. Jeśli coś pójdzie nie tak, w raporcie stron zobaczysz statusy opisane w artykule o statusach indeksowania. Ogólny przebieg procesu znajdziesz w tekście o indeksowaniu strony w Google.
Warto pamiętać, że meta tagi i kod odpowiedzi z pierwszego etapu mają znaczenie. Jeśli surowy HTML zawiera noindex, Google może w ogóle nie renderować strony, więc nie zadziała skrypt, który ten tag usuwa. Nie opieraj się na JavaScripcie do zmiany ważnych dyrektyw. Przy tagu canonical trzymaj się zasady, że lepiej mieć go od razu w HTML-u.
Ten temat to część szerszego SEO technicznego.
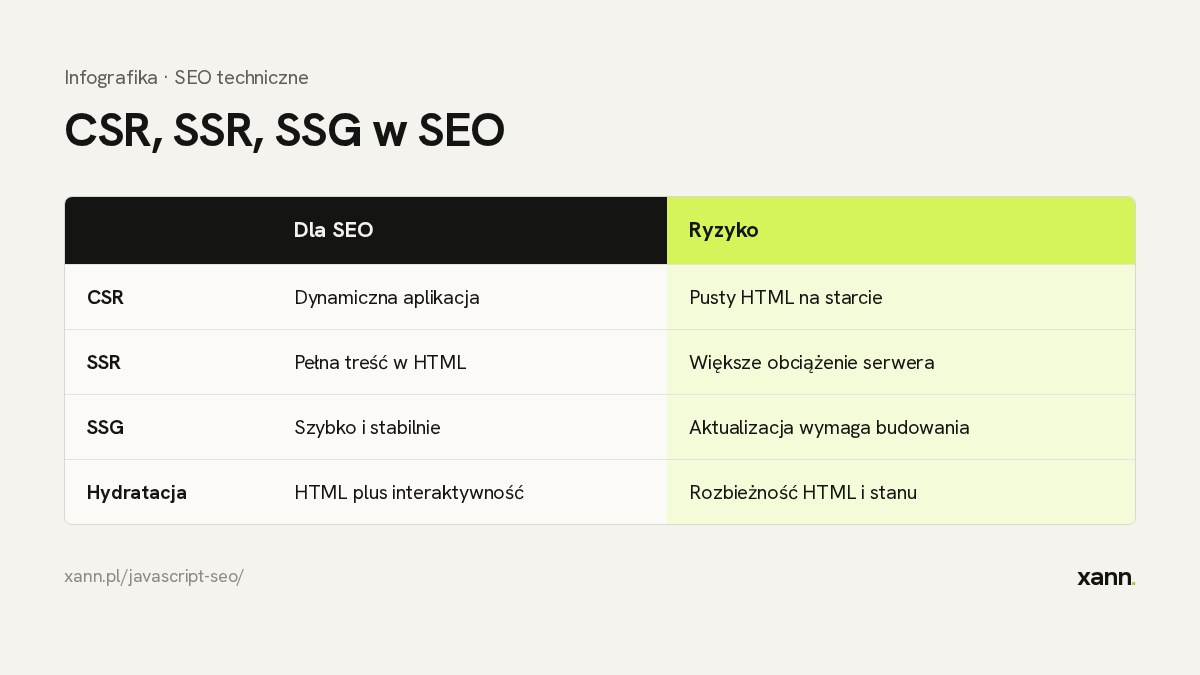
CSR, SSR, SSG i hydratacja: czym się różnią?
Różnią się tym, gdzie i kiedy powstaje gotowy HTML: na serwerze, podczas budowania strony czy w przeglądarce użytkownika. Dla SEO kluczowe jest, czy treść jest w HTML-u już w odpowiedzi serwera.
| Podejście | Gdzie powstaje HTML | Zalety dla SEO | Ryzyka |
|---|---|---|---|
| CSR (renderowanie po stronie klienta) | W przeglądarce, po wykonaniu JS | Dynamiczna aplikacja, mniej pracy serwera | Pusty HTML na starcie, zależność od renderowania, wolniejsze pierwsze wyświetlenie |
| SSR (renderowanie po stronie serwera) | Na serwerze, przy każdym żądaniu | Pełna treść w HTML-u, dobra dla robotów | Większe obciążenie serwera, trzeba pilnować czasu odpowiedzi |
| SSG (generowanie statyczne) | Podczas budowania serwisu | Szybkie, stabilne, pełny HTML | Aktualizacja wymaga ponownego zbudowania; słabe przy bardzo dużej liczbie zmiennych stron |
| Hydratacja | HTML z serwera, potem JS „ożywia” stronę w przeglądarce | Treść od razu widoczna, interaktywność po załadowaniu | Rozbieżności między HTML-em a stanem po hydratacji, większy koszt JS |
Hydratacja nie jest osobnym modelem w tym sensie, co reszta: to etap, w którym przeglądarka podpina skrypty do HTML-a wygenerowanego przez SSR lub SSG. Wiele frameworków łączy te podejścia, np. generuje część stron statycznie, a część dynamicznie.
Dawniej polecano „dynamic rendering”, czyli serwowanie robotom osobnej, wyrenderowanej wersji. Google opisuje to dziś jako obejście, a nie rozwiązanie długoterminowe, i zaleca SSR, SSG lub hydratację. Taką wersję trzeba też utrzymywać, więc koszty rosną.
Jakie są najczęstsze problemy z JavaScriptem w SEO?
Najczęstsze problemy to elementy, których robot nie wykona lub nie zobaczy: linki bez href, treść po interakcji, błędy w skryptach i zablokowane zasoby.
Linki bez znacznika a i atrybutu href
Google odkrywa adresy głównie z elementów <a href="…">. Nawigacja zbudowana na elementach div lub span z obsługą kliknięcia, albo na linkach z href="javascript:void(0)", nie przekazuje robotowi adresu. Zawsze używaj prawdziwych linków z pełnym adresem w href, nawet jeśli kliknięcie jest dodatkowo obsługiwane skryptem.
<!-- źle -->
<span onclick="przejdz('/kategoria/buty/')">Buty</span>

<!-- dobrze -->
<a href="https://example.pl/kategoria/buty/">Buty</a>
Treść ładowana po interakcji
Treść, która pojawia się dopiero po kliknięciu zakładki, rozwinięciu akordeonu przez żądanie AJAX lub po „pokaż więcej”, może nie zostać pobrana, bo robot nie wykonuje takich akcji. Jeśli tekst jest już w DOM-ie i jedynie ukryty stylami, Google zwykle go widzi. Jeśli jest dociągany dopiero po kliknięciu, ryzykujesz brak indeksacji.
Lazy loading i nieskończone przewijanie
Leniwe ładowanie obrazów atrybutem loading="lazy" jest zgodne z wytycznymi Google, o ile obrazy trafiają do widocznego obszaru w trakcie renderowania. Problem pojawia się, gdy treść lub linki do kolejnych stron wczytują się tylko po zdarzeniu przewinięcia. Przy listach produktów i blogach zapewnij zwykłą paginację z linkami do kolejnych stron.
Błędy w konsoli i zależności od API
Błąd w skrypcie potrafi przerwać budowanie strony i zostawić pusty kontener. Zadbaj o to, by awaria zewnętrznego API nie wyłączała całej treści. Sprawdzaj konsolę w narzędziach deweloperskich oraz informacje o błędach w Sprawdzaniu adresu URL.
Blokada zasobów w robots.txt
Jeśli robots.txt blokuje pliki JS, CSS lub adresy API, z których strona pobiera treść, Google nie wyrenderuje jej tak jak użytkownik. Nie blokuj katalogów z zasobami potrzebnymi do wyświetlenia strony.
User-agent: *
# nie rób tak, jeśli te pliki są potrzebne do renderowania
Disallow: /assets/js/
Disallow: /api/
Adresy z hashem i meta tagi tylko w JS
Adresy w stylu example.pl/#/produkt nie są traktowane jako osobne strony. Używaj zwykłych adresów, np. przez History API. Tytuł, opis i canonical dodawane wyłącznie skryptem są mniej niezawodne niż te w HTML-u z serwera. Pamiętaj też o kodach odpowiedzi: aplikacja jednostronicowa zwracająca zawsze 200 dla nieistniejących adresów tworzy soft 404.
Jak testować JavaScript SEO?
Najważniejsze jest porównanie surowego HTML-a z tym, co widzi Google po renderowaniu. Do tego służą dwa narzędzia Google i przeglądarka.
Sprawdzanie adresu URL w Search Console
W Google Search Console wklej adres w pasku u góry i otwórz inspekcję. Przy teście aktywnego adresu zobaczysz wyrenderowany HTML, zrzut ekranu oraz listę zasobów, których nie udało się załadować, i komunikaty z konsoli. Sprawdź, czy kluczowy tekst, nagłówki i linki są w wyrenderowanym kodzie. To odpowiednik tego, co widzi Googlebot, ale nie gwarantuje, że strona będzie zindeksowana. Szerzej o narzędziu piszemy w poradniku do Search Console.
Test wyników z elementami rozszerzonymi
Narzędzie Google do testowania wyników rozszerzonych pobiera stronę z renderowaniem i pokazuje wyrenderowany HTML oraz wykryte dane strukturalne. Jest przydatne, gdy dane strukturalne dodajesz skryptem, np. przez menedżer tagów. Dawny test optymalizacji mobilnej został wyłączony, więc nie szukaj go w narzędziach Google.
Porównanie HTML z serwera i po renderowaniu
- Otwórz „Pokaż źródło strony” i sprawdź, czy tekst jest w surowym HTML-u.
- Wyłącz JavaScript w przeglądarce i zobacz, co zostaje.
- Uruchom crawler z renderowaniem JS i bez niego, np. Screaming Frog ma obie opcje.
- Szukaj w Google fragmentu tekstu z operatorem site: w cudzysłowie, aby sprawdzić, czy został zindeksowany.
Czy boty AI wykonują JavaScript?
Według dostępnych analiz większość botów AI zbierających treści nie wykonuje JavaScriptu, więc widzą tylko HTML zwrócony przez serwer. Ta informacja pochodzi z badań firm trzecich i obserwacji logów, a nie z oficjalnych deklaracji wszystkich dostawców.
Opublikowana wspólnie przez Vercel i MERJ analiza ruchu botów (z końca 2024 r.) wskazywała, że crawlery OpenAI, Anthropic i część innych nie renderowały JS, choć mogły pobierać pliki skryptów. Wyjątki mogą dotyczyć rozwiązań związanych z infrastrukturą Google, które korzystają z jej renderowania. Zachowania botów zmieniają się, a dostawcy rzadko je szczegółowo dokumentują, dlatego traktuj te wnioski jako wskazówkę, a nie stałą regułę.
Praktyczny wniosek jest prosty: jeśli zależy Ci na cytowaniu w odpowiedziach AI, najważniejsze treści (opis oferty, ceny, FAQ, dane kontaktowe) powinny być w HTML-u odpowiedzi serwera. Więcej o tym, jak być widocznym w odpowiedziach AI, znajdziesz w naszym przewodniku po widoczności w AI. Do dopuszczania botów AI służy też robots.txt.
Jak naprawić problemy z JavaScriptem?
- Wprowadź SSR lub SSG dla stron, które mają być w wynikach wyszukiwania.
- Użyj prawdziwych linków
<a href>w nawigacji, paginacji i listach. - Umieść tytuł, opis, canonical i kluczową treść w HTML-u z serwera.
- Odblokuj w robots.txt zasoby niezbędne do renderowania.
- Zwracaj właściwe kody odpowiedzi, także w aplikacjach jednostronicowych.
- Ogranicz ilość kodu i odchudź skrypty, bo wpływają na szybkość. Szybkość i błędy serwera pomagamy poprawiać w ramach optymalizacji stron.
Najczęstsze pytania
Czy Google indeksuje strony napisane w React, Vue lub Angularze?
Tak, Google potrafi renderować takie strony. Ryzyko jest jednak większe niż przy zwykłym HTML-u, więc zadbaj o SSR lub SSG i przetestuj kluczowe adresy w Search Console.
Czy Google czeka na załadowanie całego JavaScriptu?
Nie bez końca. Renderer ma ograniczenia czasowe i zasobowe, więc treść zależna od długich lub zawodnych żądań może zostać pominięta. Najważniejsze elementy powinny być w HTML-u od początku.
Czy lazy loading szkodzi SEO?
Leniwe ładowanie obrazów jest w porządku, jeśli jest zrobione poprawnie. Problemem jest treść i linki wczytywane dopiero po przewinięciu lub kliknięciu, których robot nie wywoła.
Czy dynamic rendering nadal jest polecany?
Google opisuje go jako obejście, a nie zalecane rozwiązanie. Lepiej przejść na SSR, SSG lub hydratację, co też pomaga w szybkości i spójności.
Czy ChatGPT i inne boty AI zobaczą moją stronę w JS?
Prawdopodobnie tylko to, co jest w surowym HTML-u. Dowody pochodzą z badań i logów firm trzecich, więc najlepiej sprawdzić własne logi i wersję strony bez JavaScriptu.
Podsumowanie
JavaScript nie przekreśla SEO, ale wymaga świadomych decyzji: treść i linki mają być w HTML-u, zasoby dostępne, a kluczowe strony przetestowane w Search Console. Jeśli Twoja strona lub sklep opiera się na frameworku JS i nie wiesz, co widzą roboty, zleć audyt SEO technicznego.