Canonical (tag kanoniczny): kiedy i jak go używać
Canonical (tag kanoniczny) wskazuje Google główną wersję strony. Sprawdź, jak go wstawić, kiedy używać i jakich błędów unikać. Przykłady kodu.
Canonical (tag kanoniczny, rel="canonical") to wskazówka dla Google, który adres jest główną wersją strony, gdy ta sama lub bardzo podobna treść jest dostępna pod kilkoma adresami URL. Wyszukiwarka zbiera sygnały z kilku adresów w jedno miejsce i pokazuje w wynikach wybraną wersję. Canonical to jednak sugestia, a nie polecenie, więc Google może ją zignorować.
W skrócie
- Tag canonical wstawiasz w sekcji
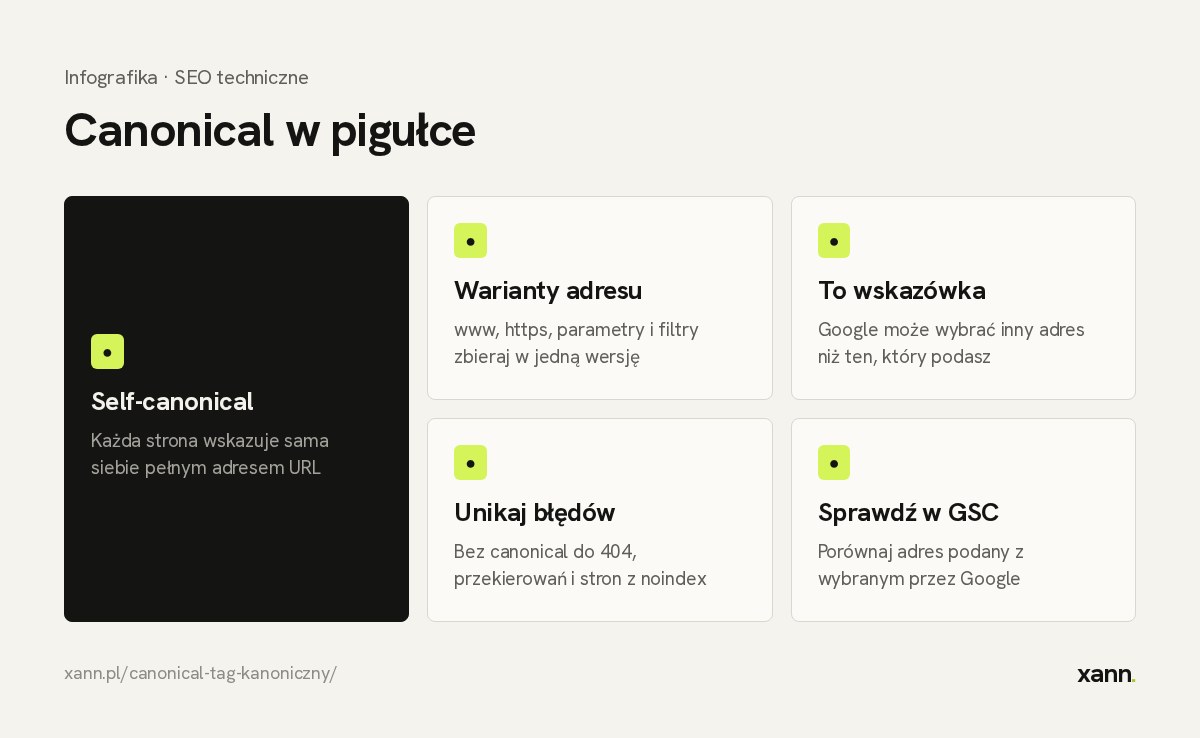
<head>jako<link rel="canonical" href="...">albo wysyłasz go w nagłówku HTTP. - Google traktuje canonical jako wskazówkę. Ostateczny wybór adresu kanonicznego podejmuje sam, na podstawie wielu sygnałów.
- Każda indeksowalna podstrona powinna mieć canonical na siebie samą (self-canonical) i to z pełnym adresem bezwzględnym.
- Canonical nie powinien wskazywać na adres z błędem 404, na przekierowanie ani na stronę z noindex.
- Do trwałego przeniesienia strony służy przekierowanie 301, a nie canonical.
- Adres wybrany przez Google sprawdzisz w Search Console, w narzędziu „Sprawdzanie adresu URL”.
Do czego służy tag canonical?
Tag canonical służy do wskazania wersji strony, którą wyszukiwarka ma traktować jako oryginał, kiedy podobna treść jest dostępna pod więcej niż jednym adresem. Dzięki temu sygnały takie jak linki przychodzące nie rozpraszają się między kopie, a w wynikach wyszukiwania pojawia się ten adres, na którym zależy właścicielowi.
Duplikaty adresów powstają zwykle bez złej woli. Ta sama strona działa z www i bez, z ukośnikiem na końcu i bez, z parametrem śledzącym UTM, po sortowaniu listy produktów albo w wersji do wydruku. Dla człowieka to jedna strona, dla robota to kilka różnych adresów. Canonical porządkuje tę sytuację. To jedna z podstaw SEO technicznego.
Warto wiedzieć, że duplikaty nie skutkują karą. Google po prostu wybiera jedną wersję do pokazania i resztę pomija. Problem pojawia się wtedy, gdy wybierze inną, niż byś chciał.
Jak wygląda tag canonical?
Najczęściej tag canonical to jedna linijka w sekcji <head> dokumentu HTML, z pełnym adresem URL strony kanonicznej.
<head>
  <title>Buty trekkingowe damskie</title>
  <link rel="canonical" href="https://example.pl/buty-trekkingowe-damskie/">
</head>
Dla plików innych niż HTML, na przykład PDF-ów, canonical można przekazać w nagłówku odpowiedzi HTTP:
Link: <https://example.pl/oferta/katalog.pdf>; rel="canonical"Kilka zasad, które oszczędzają kłopotów:
- używaj adresów bezwzględnych (z
https://i domeną), a nie względnych, bo łatwo o pomyłkę; - wstawiaj tylko jeden tag canonical na stronę, bo przy kilku sprzecznych Google je zignoruje;
- umieszczaj go w
<head>, ponieważ tag w<body>nie jest brany pod uwagę; - pilnuj spójności z mapą strony: w sitemap XML powinny być adresy kanoniczne. Więcej o tym w poradniku o mapie strony.
Kiedy używać canonical?
Canonical stosuje się wszędzie tam, gdzie jedna treść ma kilka adresów, a Ty chcesz zachować wszystkie te adresy dostępne dla użytkowników. Jeśli adres ma przestać działać, lepsze jest przekierowanie.
Warianty adresu: www, https, ukośnik
Wersje http i https oraz www i bez www to cztery różne adresy tej samej strony. Podstawą jest tu przekierowanie na jedną wersję (opisane w artykule o przekierowaniu 301), a canonical działa jako dodatkowe zabezpieczenie. Samo przekierowanie z http na https omawiamy też w starszym wpisie o przekierowaniu HTTP na HTTPS.
Parametry w adresie
Adresy z parametrami śledzącymi, na przykład ?utm_source=newsletter, wyświetlają tę samą treść co adres bez parametru, więc powinny wskazywać canonical na wersję czystą. To częsty przypadek, jeśli korzystasz ze znaczników UTM. Samoistnie canonical rozwiązuje to dobrze, bo strona z parametrem nadal działa, a sygnały trafiają na adres główny.
Filtry i sortowanie w sklepach
W sklepach filtry (kolor, rozmiar, cena) i sortowanie tworzą ogromną liczbę adresów. Jeśli filtr tylko zmienia kolejność lub zawęża listę bez wartości wyszukiwawczej, canonical na stronę kategorii jest rozsądnym wyborem. Jeśli jednak dana kombinacja odpowiada na realne zapytanie (na przykład „czerwone buty trekkingowe damskie”), warto dać jej własny, indeksowalny adres z unikalną treścią i self-canonical. Google w swojej dokumentacji o nawigacji fasetowej wskazuje kilka dróg: canonical, noindex albo blokadę w robots.txt. Każda ma wady, więc to decyzja zależna od skali sklepu. Przy bardzo dużej liczbie filtrów dochodzi jeszcze temat crawl budgetu.
Paginacja
Przy stronach podzielonych na części (?page=2, ?page=3) najbezpieczniej jest nadać każdej stronie canonical wskazujący na nią samą. Błędem jest kierowanie wszystkich stron paginacji na stronę pierwszą, ponieważ strony 2 i dalsze mają inną zawartość (inne produkty czy wpisy), a robot może przestać do nich docierać. Pamiętaj, że Google od lat nie korzysta z rel="prev" i rel="next" jako sygnału indeksowania, więc dobre linkowanie wewnętrzne między stronami listy ma tu większe znaczenie. Zobacz też optymalizację linkowania wewnętrznego.
Syndykacja i kopie treści
Gdy publikujesz ten sam tekst na innej domenie (na przykład gościnnie), partner może dać canonical na Twój oryginał. Jest to dozwolone między domenami, ale tylko wskazówka, więc nie ma gwarancji, że Google ją uszanuje.
Co to jest self-canonical i czy jest potrzebny?
Self-canonical to tag canonical, który wskazuje adres samej strony, na której się znajduje. Jest zalecany, bo chroni przed nieoczekiwanymi duplikatami, które powstają przez parametry doklejane do adresu przez narzędzia, linki zewnętrzne czy wtyczki.
Jeśli ktoś doklei do Twojego adresu ?fbclid=abc, strona z self-canonical nadal wskazuje czysty adres. Bez tagu Google musi sam zgadywać. W WordPressie self-canonical zwykle dodaje się automatycznie (rdzeń WordPressa albo wtyczka SEO), ale warto to sprawdzić, bo wtyczki, motywy i cache czasem generują błędne wartości.
Najczęstsze błędy z canonical
Najczęstsze błędy to wskazywanie canonical na adres, który nie jest dobrym celem, oraz wysyłanie przeciwnych sygnałów. Każdy z nich osłabia lub unieważnia tag.
Canonical do adresu 404
Jeśli tag wskazuje stronę, która nie istnieje, Google nie ma gdzie przenieść sygnałów i prawdopodobnie zignoruje wskazówkę. Zdarza się to po usunięciu podstrony lub zmianie adresu bez aktualizacji tagu.
Canonical do adresu z przekierowaniem
Tag powinien prowadzić bezpośrednio do ostatecznego adresu, a nie do takiego, który dalej przekierowuje. To typowy skutek migracji, gdy w szablonie został stary adres. Więcej o łańcuchach przekierowań w artykule o przekierowaniu 301.
Canonical razem z noindex
Tag canonical na inny adres i jednocześnie noindex to sprzeczne polecenia: jedno mówi „zbierz sygnały w innym miejscu”, drugie „usuń tę stronę z indeksu”. Google dokumentuje, że nie należy łączyć tych dwóch sygnałów. Wybierz jedną metodę, zależnie od celu.
Sprzeczne sygnały
Canonical wskazuje jeden adres, a mapa strony, linki wewnętrzne, przekierowania i hreflang wskazują inny. Google waży wszystkie sygnały razem i przy sprzeczności może wybrać własnego faworyta. Spójność jest ważniejsza niż sam tag. Przy wersjach językowych pamiętaj, że każda wersja ma canonical na siebie, a nie na wersję główną (więcej w artykule o hreflang).
Canonical wszystkich stron na stronę główną
Zdarza się, że ustawienie w szablonie kieruje canonical każdej podstrony na stronę główną. Google zwykle to wykrywa i ignoruje, ale w gorszym przypadku podstrony wypadają z indeksu.
Canonical wstawiany przez JavaScript
Google potrafi odczytać tag dodany skryptem, ale jest to rozwiązanie mniej pewne. Jeśli to możliwe, tag powinien być w kodzie źródłowym odpowiedzi serwera. Szerzej o tym w tekście o JavaScript SEO.
Canonical to wskazówka, nie dyrektywa
Canonical jest sygnałem, a nie rozkazem, więc Google może wybrać inny adres kanoniczny niż ten, który wskażesz. Przy wyborze bierze pod uwagę między innymi przekierowania, tag canonical, adresy w mapie strony, linki wewnętrzne i zewnętrzne oraz protokół HTTPS.
W praktyce oznacza to, że przy zignorowanej wskazówce nie ma sensu dodawać kolejnych tagów. Trzeba znaleźć rozbieżność między sygnałami: czy strony faktycznie są podobne, czy linki wewnętrzne nie prowadzą do innego wariantu, czy w sitemap nie ma adresów z parametrami. Gdy dwie strony mają różną treść, canonical zwykle zostanie zignorowany, bo to nie są duplikaty.
Jeśli potrzebujesz twardego efektu, na przykład całkowitego usunięcia adresu z użycia, sięgnij po przekierowanie 301. Jeśli chcesz, aby strona nie była w wynikach, ale ma działać dla użytkowników, użyj noindex. Blokada w robots.txt nie jest tu dobrym rozwiązaniem, o czym piszemy w poradniku o pliku robots.txt.
Jak sprawdzić canonical w Google Search Console?
Najprościej sprawdzić to w narzędziu „Sprawdzanie adresu URL” w Search Console, które pokazuje zarówno canonical zadeklarowany przez Ciebie, jak i ten wybrany przez Google. Jeśli się różnią, Google nie przyjął Twojej wskazówki.
- Wklej adres w pole wyszukiwania na górze Search Console.
- Rozwiń sekcję „Indeksowanie” i odczytaj „Podany przez użytkownika adres kanoniczny” oraz „Wybrany przez Google adres kanoniczny”.
- Jeśli adresy się różnią, porównaj treść obu stron, mapę strony i linkowanie wewnętrzne.
W raporcie „Strony” (indeksowanie) zobaczysz też statusy związane z canonical, na przykład „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” czy „Duplikat: Google wybrał inną stronę kanoniczną niż użytkownik”. Ich znaczenie opisujemy w artykule o statusach indeksowania w Search Console. Jeśli dopiero zaczynasz pracę z tym narzędziem, zajrzyj do poradnika po Google Search Console.
Poza Search Console pomocne są crawlery, które zbiorczo pokazują canonical dla wszystkich adresów, na przykład Screaming Frog (jak zrobić w nim audyt). Kontrola tagów to też jeden z punktów w naszej liście 50 czynników technicznego SEO.
Najczęstsze pytania
Czy canonical przekazuje moc linków?
Google używa canonical do konsolidacji sygnałów, w tym linków, na wybrany adres. Nie jest to jednak gwarantowane, ponieważ tag jest wskazówką. Do trwałego przeniesienia mocy najpewniejsze jest przekierowanie 301.
Czy każda strona powinna mieć canonical?
Tak, każda indeksowalna strona powinna mieć canonical wskazujący na nią samą. To prosty sposób na ograniczenie problemów z duplikatami powstającymi przez parametry w adresie.
Czy mogę użyć canonical między różnymi domenami?
Tak, Google dopuszcza canonical między domenami, na przykład przy publikacji gościnnej lub syndykacji. Nadal jest to jedynie wskazówka, więc kopia na innej domenie może się wyświetlać zamiast oryginału.
Czy canonical i noindex można łączyć?
Nie warto. Te dwa sygnały mówią co innego i mogą dać nieprzewidywalny efekt. Jeśli strona ma być poza indeksem, użyj noindex, a jeśli ma być duplikatem innej strony, użyj canonical.
Jak długo trwa zmiana adresu kanonicznego w Google?
Zależy od tego, jak często robot odwiedza strony. Może to potrwać od kilku dni do kilku tygodni. Po poprawce możesz poprosić o ponowne zindeksowanie adresu w narzędziu do sprawdzania adresów URL.
Podsumowanie
Canonical to prosty tag, który w praktyce pomaga uporządkować duplikaty, o ile jest spójny z resztą sygnałów: przekierowaniami, mapą strony i linkami wewnętrznymi. Najważniejsze zasady to self-canonical na każdej stronie, brak canonical do 404 i przekierowań oraz niełączenie go z noindex. Jeśli chcesz, żebyśmy sprawdzili duplikaty i canonicale w Twoim serwisie, zajrzyj do oferty SEO technicznego albo zamów audyt SEO.