Crawl budget: czy Twoja strona musi o niego dbać
Crawl budget to limit skanowania strony przez Googlebota. Sprawdź, komu naprawdę dotyczy, co go marnuje i jak go sprawdzić w Search Console i logach.
Crawl budget (budżet indeksowania) to liczba adresów URL, które Googlebot jest w stanie i chce przeskanować na Twojej stronie w danym czasie. Według Google wynika on z dwóch czynników: limitu wydajności skanowania (ile serwer wytrzyma) oraz zapotrzebowania na skanowanie (ile Google ma powodów, by wracać). Dla większości małych i średnich stron nie jest to realny problem.
W skrócie
- Crawl budget = limit wydajności skanowania + zapotrzebowanie na skanowanie (crawl demand). Liczy się to, co niższe z tych dwóch pojęć w praktyce.
- Google opisuje poradnik o budżecie jako przeznaczony dla dużych serwisów: ok. 1 mln+ unikalnych stron zmienianych mniej więcej raz w tygodniu albo 10 tys.+ stron zmienianych codziennie.
- Budżet marnują m.in. parametry w adresach, filtry w sklepach, duplikaty, łańcuchy przekierowań i soft 404.
- Najprostsze źródło danych to raport „Statystyki indeksowania” w Google Search Console oraz logi serwera.
- Blokada w robots.txt i usuwanie zbędnych adresów działają lepiej niż tag noindex, bo noindex nie zatrzymuje skanowania.
Co to jest crawl budget i z czego się składa?
Crawl budget to zakres skanowania, jaki Google przeznacza na Twoją witrynę, a składają się na niego dwa elementy opisane w dokumentacji Google: crawl capacity limit i crawl demand.
Limit wydajności skanowania (crawl capacity limit)
Googlebot nie chce przeciążyć serwera, więc dobiera liczbę równoległych połączeń i przerwy między zapytaniami do tego, jak szybko i stabilnie strona odpowiada. Gdy serwer odpowiada szybko, limit rośnie. Gdy pojawiają się błędy 5xx lub długie odpowiedzi, Google zwalnia. Limit zależy też od zasobów samego Google, które nie są nieograniczone.
Zapotrzebowanie na skanowanie (crawl demand)
Crawl demand mówi, ile Google chce skanować. Zależy od wielkości witryny, popularności adresów, ich aktualności i tego, jak często treść faktycznie się zmienia. Strony, które się nie zmieniają i nikt do nich nie linkuje, są odwiedzane rzadziej. Duże zmiany w witrynie, np. migracja, zwykle zwiększają zapotrzebowanie, bo Google musi ponownie przejrzeć adresy.
Jeśli Google ma ochotę skanować więcej, ale serwer nie nadąża, ogranicza go limit. Jeśli serwer jest szybki, a Google nie widzi powodu, by wracać, ogranicza go zapotrzebowanie. Dlatego sam szybszy serwer nie zawsze zwiększy liczbę skanowanych adresów.
Czy Twoja strona musi dbać o crawl budget?
Zwykle nie: Google wprost kieruje swój poradnik do właścicieli dużych witryn. Dokumentacja wymienia dwa progi: serwisy z ponad milionem unikalnych stron, których treść zmienia się mniej więcej raz w tygodniu, oraz średnie i większe serwisy z ponad 10 tysiącami stron zmienianych codziennie. Poradnik dotyczy też stron, na których Search Console pokazuje dużo adresów ze statusem „Wykryto – obecnie nie zindeksowano”.
To są wartości orientacyjne, nie sztywna granica. Mała firmowa strona z 80 podstronami czy blog z kilkuset wpisami nie ma problemu z budżetem. Jeśli ich nowe wpisy nie trafiają do indeksu, najczęściej winna jest jakość treści, brak linków wewnętrznych, błędy techniczne albo kanonikalizacja, a nie limit skanowania. Wtedy zajrzyj do artykułu o tym, dlaczego Google nie indeksuje strony, i do statusów indeksowania w Search Console.
Realnie crawl budget interesuje: duże sklepy internetowe z filtrami i sortowaniem, serwisy ogłoszeniowe, portale z archiwami, strony z wieloma wersjami językowymi oraz serwisy generujące adresy dynamicznie. To obszar SEO technicznego, bo chodzi o architekturę i konfigurację, a nie o treść.
Co marnuje budżet indeksowania?
Budżet marnują adresy, które nie wnoszą nic nowego do indeksu, a Googlebot i tak musi je pobrać. Google wskazuje na tej liście m.in. zduplikowaną treść, nawigację fasetową i identyfikatory sesji, soft 404, zhakowane strony, nieskończone przestrzenie (np. kalendarze), treści niskiej jakości i spam.
Parametry i filtry
Sklep z filtrami koloru, rozmiaru, ceny i sortowania potrafi wygenerować miliony kombinacji adresów, które pokazują prawie te same produkty. Parametry śledzące (UTM, identyfikatory sesji) dokładają kolejne wersje tej samej strony. O tym, jak ogarnąć tagi w linkach, piszemy w tekście o tagach UTM.
Duplikaty i niejasne wersje adresów
Wersje z i bez ukośnika na końcu, http i https, www i bez www, wersje drukowania. Każda to osobny adres do skanowania, jeśli nie zostały uporządkowane przekierowaniem i tagiem canonical.
Łańcuchy przekierowań
Gdy adres A przekierowuje na B, B na C, a C na D, Googlebot zużywa kilka żądań zamiast jednego. Google śledzi ograniczoną liczbę przekierowań w łańcuchu, a dłuższe mogą się nie zakończyć. Linkuj od razu do adresu docelowego. Więcej o poprawnych przekierowaniach znajdziesz w artykule o przekierowaniu 301.
Soft 404 i błędy
Soft 404 to strona, która wyświetla komunikat „nie znaleziono” (lub jest pusta), ale zwraca kod 200. Google traktuje ją jak błąd, ale musi ją najpierw pobrać i ocenić. Strony naprawdę usunięte powinny zwracać 404 lub 410. Google zaznacza, że 404 jest skanowane rzadziej niż 200, ale nie przestaje ich skanować od razu. Podobnie błędy serwera: gdy pojawiają się często, błąd 500 obniża limit skanowania.
Wolne odpowiedzi serwera
Im dłużej serwer odpowiada, tym mniej adresów Googlebot pobierze w tym samym czasie. To jeden z powodów, dla których warto zadbać o szybkość, o której piszemy też w tekście o Core Web Vitals.
Jak sprawdzić, na co Googlebot zużywa budżet?
Najprościej sprawdzić to w raporcie „Statystyki indeksowania” w Google Search Console, a dokładniej w logach serwera.
Raport Statystyki indeksowania w GSC
Wejdź w Ustawienia, a następnie w sekcję Skanowanie i otwórz raport statystyk indeksowania. Zobaczysz łączną liczbę żądań, łączny rozmiar pobranych danych i średni czas odpowiedzi, a także podział żądań według kodu odpowiedzi, typu pliku, celu (odkrywanie nowych adresów kontra odświeżanie) i typu Googlebota. Na co zwrócić uwagę:
- wysoki odsetek żądań z kodem 3xx, 4xx lub 5xx,
- duży udział żądań „odkrywanie” przy braku nowych treści (sygnał, że Google krąży po parametrach),
- rosnący średni czas odpowiedzi,
- problemy z hostem (dostępność pliku robots.txt, DNS, łączność z serwerem).
Raport jest dostępny dla właściwości domenowych oraz prefiksów adresu na poziomie katalogu głównego. Ogólne wprowadzenie do narzędzia znajdziesz w poradniku do Google Search Console.
Logi serwera
Logi pokazują każde żądanie Googlebota: adres, kod odpowiedzi, czas i datę. Dzięki nim zobaczysz, które sekcje są skanowane najczęściej, ile żądań idzie na adresy z parametrami i które ważne podstrony Googlebot odwiedza rzadko. Pamiętaj, że w logach pod nazwą Googlebota potrafią występować podszywające się boty, więc weryfikuj ruch po adresach IP Google. Do wstępnej analizy struktury pomaga też crawler, np. Screaming Frog, który pokaże duplikaty, łańcuchy przekierowań i osierocone adresy.
Jak zoptymalizować crawl budget?
Optymalizacja polega na tym, by Googlebot spędzał czas na adresach, które mają trafić do indeksu, a omijał resztę. Poniżej kolejność, którą stosujemy zwykle w audytach.
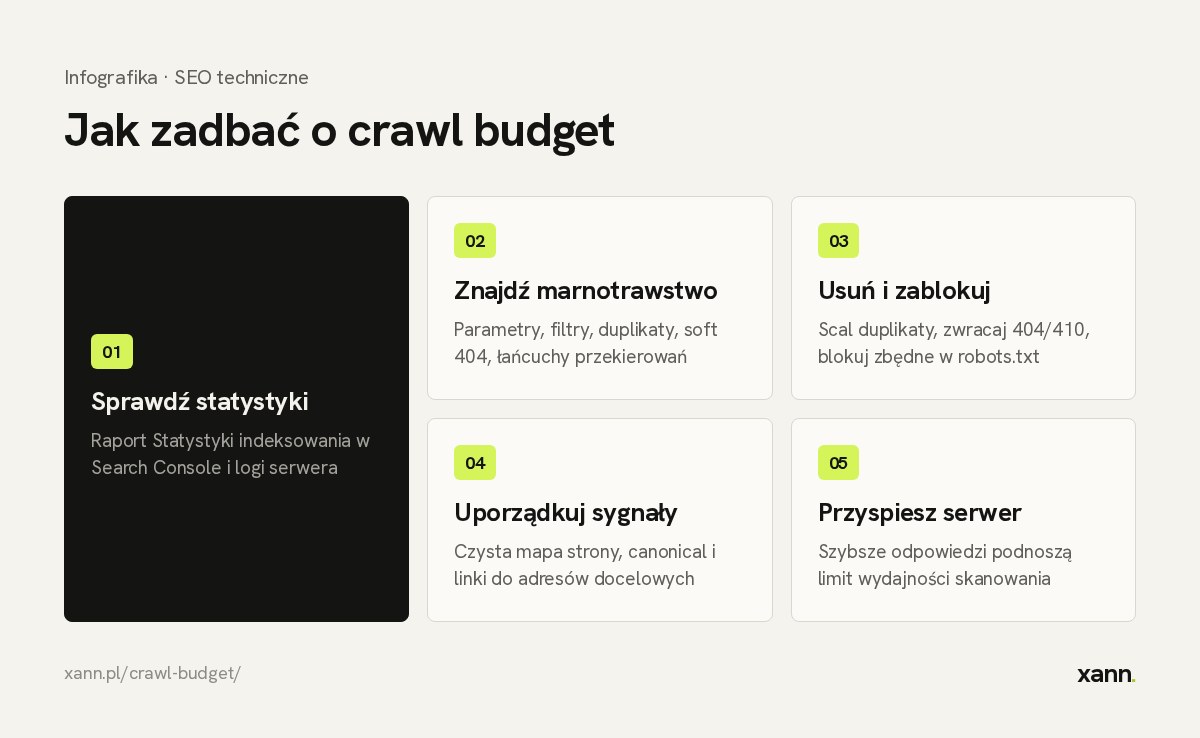
- Usuń lub scal zbędne adresy. Najskuteczniej działa pozbycie się duplikatów i pustych stron, a nie ich ukrywanie.
- Zablokuj przestrzenie bez wartości w robots.txt. Dotyczy to np. wewnętrznej wyszukiwarki, koszyka i kombinacji filtrów. Przykład niżej. Szczegóły w artykule o pliku robots.txt.
- Nie polegaj na noindex jako sposobie oszczędzania budżetu. Google musi pobrać stronę, by zobaczyć tag, więc żądanie i tak się odbywa.
- Zwracaj poprawne kody. 404 lub 410 dla usuniętych stron, 301 dla przeniesionych, bez soft 404.
- Skróć łańcuchy przekierowań i popraw linki wewnętrzne, aby wskazywały adres docelowy.
- Utrzymuj aktualną mapę strony zawierającą tylko adresy kanoniczne, które mają być w indeksie. Pomaga w tym mapa strony XML, a jej pole lastmod warto uzupełniać rzetelnie, tylko przy faktycznych zmianach.
- Popraw wydajność serwera. Szybsze odpowiedzi podnoszą limit wydajności skanowania.
- Wzmocnij linkowanie wewnętrzne do ważnych podstron, zgodnie z zasadami z tekstu o optymalizacji linkowania wewnętrznego.
Przykład reguł blokujących parametry i wyszukiwarkę wewnętrzną (dopasuj do swojej struktury i przetestuj przed wdrożeniem):
User-agent: *
Disallow: /szukaj/
Disallow: /*?sortuj=
Disallow: /*?sesja=
Sitemap: https://example.pl/sitemap.xml
Uwaga: zablokowanego adresu Google nie przeskanuje, więc nie zobaczy też na nim tagu canonical ani noindex. Nie blokuj stron, które mają przekazywać sygnały lub które chcesz usunąć z indeksu przez noindex. Dawne narzędzie do ograniczania szybkości skanowania w Search Console zostało wycofane, a przy awarii serwera zalecane jest tymczasowe zwracanie kodów 503 lub 429. Ten sposób stosuj tylko krótkotrwale.
Czy crawl budget wpływa na pozycje?
Bezpośrednio nie: Google zaznacza, że częstsze skanowanie nie jest czynnikiem rankingowym. Budżet decyduje o tym, czy i jak szybko nowa lub zmieniona strona zostanie odkryta, a dopiero potem oceniona. Jeśli ważne adresy nie są skanowane, nie mogą się dobrze pozycjonować, ale samo skanowanie pozycji nie gwarantuje. O przebiegu całego procesu piszemy w artykule o indeksowaniu strony w Google.
Najczęstsze pytania
Ile wynosi crawl budget mojej strony?
Google nie podaje jednej liczby dla witryny. Orientacyjnie zobaczysz, ile żądań dziennie wykonuje Googlebot, w raporcie Statystyki indeksowania w Search Console. Wartość zmienia się z dnia na dzień.
Czy mała strona firmowa musi się przejmować crawl budgetem?
Zwykle nie. Poradnik Google jest skierowany do dużych serwisów, np. z ponad milionem stron albo ponad 10 tysiącami stron zmienianych codziennie. Przy małej stronie szukaj przyczyn problemów z indeksacją gdzie indziej, np. w jakości treści lub linkowaniu wewnętrznym.
Czy noindex oszczędza budżet indeksowania?
Nie. Google musi pobrać stronę, żeby odczytać tag noindex. Z czasem może skanować taki adres rzadziej, ale żądania nie znikają od razu. Do oszczędzania budżetu lepiej nadają się usunięcie adresów, poprawne kody 404 lub 410 i blokada w robots.txt.
Czy mapa strony zwiększa crawl budget?
Nie zwiększa go, ale pomaga Google znaleźć ważne adresy i wskazać, co się zmieniło. Mapa powinna zawierać wyłącznie adresy kanoniczne, zwracające kod 200.
Jak szybko poprawki wpływają na skanowanie?
Zmiany widać zwykle po kilku dniach lub tygodniach i zależą od rozmiaru serwisu. Obserwuj raport Statystyki indeksowania i logi, zamiast czekać na efekt w pozycjach.
Podsumowanie
Crawl budget jest tematem dla dużych serwisów, a dla pozostałych bywa wymówką, która odciąga uwagę od prawdziwych przyczyn. Zacznij od raportu Statystyki indeksowania, usuń duplikaty, skróć przekierowania i zadbaj o czystą mapę strony. Jeśli prowadzisz duży sklep lub portal i nie wiesz, gdzie ucieka budżet, zleć nam audyt SEO technicznego, a zakres kontroli opisujemy w tekście o czynnikach, które audytujemy.