Google nie indeksuje strony najczęściej z jednego z kilku powodów: robot nie może jej pobrać (blokada w robots.txt, hasło, błąd serwera), dostał polecenie, by jej nie indeksować (noindex), uznał ją za duplikat innej strony albo ocenił, że nie jest wystarczająco wartościowa, by trafiła do indeksu. Przyczynę w większości przypadków wskaże raport „Strony” i narzędzie do sprawdzania adresów URL w Google Search Console. Poniżej znajdziesz sposób diagnozy krok po kroku i rozwiązania dla każdej z przyczyn.
W skrócie
- Najpewniejszym sposobem sprawdzenia, czy strona jest w indeksie Google, jest narzędzie do sprawdzania adresów URL w Google Search Console, a nie samo polecenie site:.
- Najczęstsze techniczne przyczyny braku indeksowania to tag noindex, blokada w robots.txt, nagłówek X-Robots-Tag, przekierowanie, błędny canonical i strona dostępna tylko po zalogowaniu.
- Status „Strona zeskanowana, ale obecnie nie zindeksowana” zwykle oznacza problem z jakością lub unikalnością treści, a nie błąd techniczny.
- Blokada w robots.txt nie gwarantuje, że adres nie pojawi się w Google – do wykluczenia strony z indeksu służy noindex.
- Nowe strony przyspieszysz linkami wewnętrznymi, aktualną mapą witryny i prośbą o zindeksowanie w Search Console.
Jak sprawdzić, czy strona jest w indeksie Google?
Najdokładniej sprawdzisz to w Google Search Console: wpisz adres w pasku „Sprawdź dowolny URL” na górze panelu, a narzędzie pokaże, czy adres jest w indeksie, kiedy był ostatnio skanowany i dlaczego ewentualnie nie został zindeksowany.

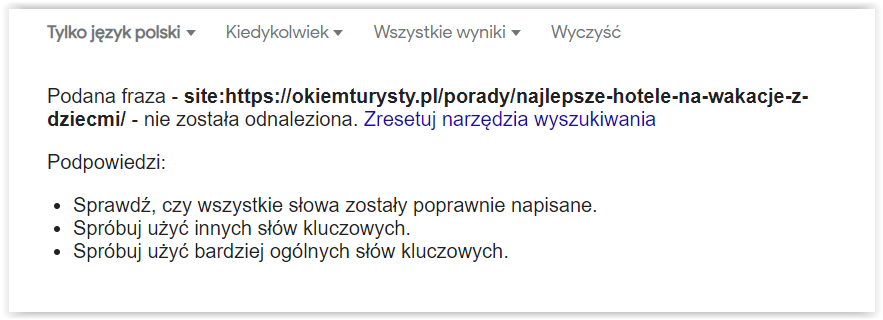
Szybkim, ale mniej precyzyjnym sposobem jest polecenie site: w wyszukiwarce, np. site:twojastrona.pl/nazwa-podstrony/. Jeśli Google nic nie znajdzie, zobaczysz komunikat o braku wyników.
Pamiętaj, że polecenie site: nie pokazuje pełnej listy zaindeksowanych adresów, a liczba wyników jest tylko szacunkowa. Brak strony na wysokich pozycjach na wpisany tytuł też nie oznacza, że nie jest w indeksie – może po prostu przegrywać z innymi wynikami.
Gdzie w Search Console sprawdzić przyczyny braku indeksowania?
Przyczyny dla całego serwisu znajdziesz w raporcie „Strony” (Indeksowanie → Strony). Pokazuje on liczbę zindeksowanych i niezindeksowanych adresów oraz listę powodów, dla których część adresów nie trafiła do indeksu. Najważniejsze statusy i ich znaczenie zebraliśmy w tabeli.
| Status w raporcie „Strony” | Co oznacza | Co zrobić |
|---|---|---|
| Wykluczona za pomocą tagu „noindex” | Strona ma meta tag lub nagłówek noindex | Usuń noindex, jeśli strona ma być w Google |
| Zablokowana przez plik robots.txt | Robot nie może pobrać strony | Popraw regułę Disallow w robots.txt |
| Strona z przekierowaniem | Adres przekierowuje na inny | Normalne dla starych adresów; sprawdź, czy w mapie witryny i linkach są adresy docelowe |
| Duplikat, użytkownik nie oznaczył strony kanonicznej / Google wybrał inną stronę kanoniczną | Google uznał inną stronę za główną wersję | Ujednolić canonical, połączyć lub zróżnicować treści |
| Nie znaleziono (404) / Soft 404 | Strona nie istnieje albo wygląda na pustą | Przywróć treść, przekieruj lub zostaw 404 dla usuniętych stron |
| Błąd serwera (5xx) | Serwer nie odpowiedział poprawnie | Sprawdź hosting, limity, logi serwera |
| Strona wykryta – obecnie nie zindeksowana | Google zna adres, ale jeszcze go nie skanował | Wzmocnij linkowanie wewnętrzne, sprawdź wydajność serwera |
| Strona zeskanowana, ale obecnie nie zindeksowana | Google pobrał stronę, ale nie dodał jej do indeksu | Popraw jakość i unikalność treści, połącz cienkie strony |
Opis wszystkich statusów znajdziesz w pomocy Google do raportu indeksowania stron. Część adresów niezindeksowanych to zjawisko normalne (przekierowania, strony z parametrami, celowo wykluczone podstrony) – niepokój powinny budzić ważne strony ofertowe, kategorie i artykuły.
Czy tag noindex blokuje indeksowanie strony?
Tak, tag noindex to bezpośrednie polecenie dla Google, by nie umieszczało strony w indeksie. Bardzo często zostaje na stronie przez pomyłkę – dodany na etapie budowy serwisu i niezdjęty po publikacji albo ustawiony w wtyczce SEO dla całej kategorii treści.
W kodzie HTML strony blokada wygląda tak:
<meta name=”robots” content=”noindex, nofollow”>
Jeśli strona ma być w Google, usuń ten znacznik albo zmień go na:
<meta name=”robots” content=”index, follow”>
Wartość „index, follow” jest domyślna, więc wystarczy, że znacznika noindex po prostu nie będzie. Sprawdzisz to w kodzie źródłowym strony (Ctrl+U i wyszukanie „noindex”) albo w narzędziu do sprawdzania adresów URL w Search Console, które pokaże, czy indeksowanie jest dozwolone.
Nagłówek X-Robots-Tag
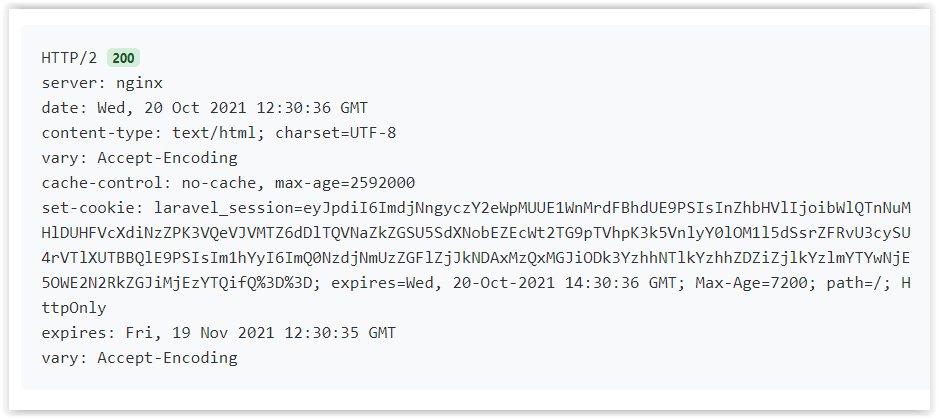
Ten sam efekt co meta tag daje nagłówek odpowiedzi HTTP X-Robots-Tag: noindex. Nie zobaczysz go w kodzie strony, bo jest wysyłany przez serwer – często stosuje się go dla plików PDF i obrazów. Ustawia się go w konfiguracji serwera (np. w pliku .htaccess na serwerach Apache lub w konfiguracji Nginx) albo w aplikacji. Aby strona mogła być indeksowana, usuń dyrektywę noindex z nagłówka.
Nagłówki sprawdzisz w zakładce „Sieć” w Chrome DevTools (kliknij dokument i otwórz sekcję nagłówków odpowiedzi) lub w dowolnym narzędziu do podglądu nagłówków HTTP.
Czy blokada w robots.txt wyklucza stronę z Google?
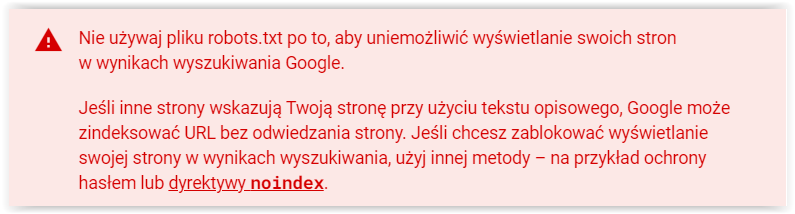
Blokada w robots.txt zabrania robotowi pobierania strony, ale nie gwarantuje, że adres nie pojawi się w wynikach. Jeśli do zablokowanej strony prowadzą linki, Google może ją zindeksować bez znajomości treści – wtedy w wynikach widać sam adres bez opisu, a w Search Console status „Zindeksowana, mimo blokady w robots.txt”.
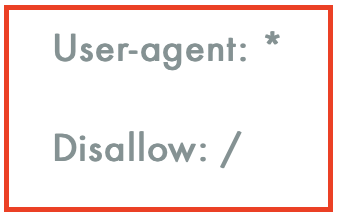
Najczęstszy problem jest odwrotny: deweloper blokuje cały serwis na czas budowy i zapomina zdjąć blokadę po starcie. Reguła blokująca dostęp wszystkim robotom do całej strony wygląda tak:
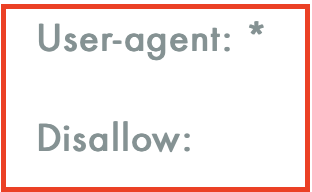
Jeśli nie chcesz niczego blokować, plik powinien wyglądać tak (pusta reguła Disallow oznacza brak ograniczeń):
Zawartość i błędy pliku sprawdzisz w raporcie robots.txt w Search Console (Ustawienia → robots.txt). Pod koniec 2023 roku zastąpił on dawny tester robots.txt. Ważna zasada: nie blokuj w robots.txt stron, które chcesz wykluczyć tagiem noindex – robot, który nie może pobrać strony, nie zobaczy też tagu noindex.
Dlaczego nowa strona nie pojawia się w Google?
Nowa strona często po prostu nie została jeszcze odkryta albo zeskanowana. Google znajduje adresy głównie przez linki i mapy witryny, więc strona, do której nic nie prowadzi, może czekać na indeksowanie tygodniami.
Co zrobić, by przyspieszyć indeksowanie:
- Dodaj stronę w Google Search Console i zweryfikuj ją (najlepiej jako usługę domeny).
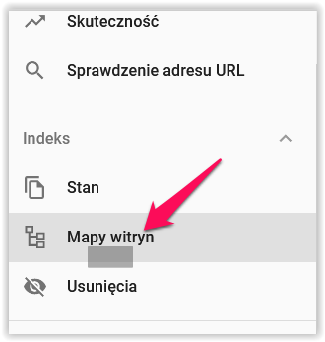
- Przygotuj mapę witryny XML i prześlij ją w raporcie „Mapy witryn”. Jak to zrobić, opisujemy w artykule jak utworzyć i wykorzystać mapę strony.
- Podlinkuj nową podstronę z miejsc, które Google odwiedza często: strony głównej, menu, kategorii, popularnych artykułów. Zasady opisujemy w tekście o optymalizacji linkowania wewnętrznego.
- W narzędziu do sprawdzania adresów URL kliknij „Poproś o zindeksowanie”. Liczba takich próśb jest dzienna i ograniczona, więc używaj jej dla najważniejszych adresów.
- Zdobądź pierwsze linki zewnętrzne, np. z profilu firmy, katalogów branżowych, mediów społecznościowych i od partnerów.
Jakie inne przyczyny mogą blokować indeksowanie?
Oprócz noindex i robots.txt indeksowanie blokują najczęściej przekierowania, błędne tagi canonical, treści dostępne tylko po zalogowaniu, problemy z serwerem, ustawienia CMS i niska jakość treści.
Przekierowanie i błędny canonical
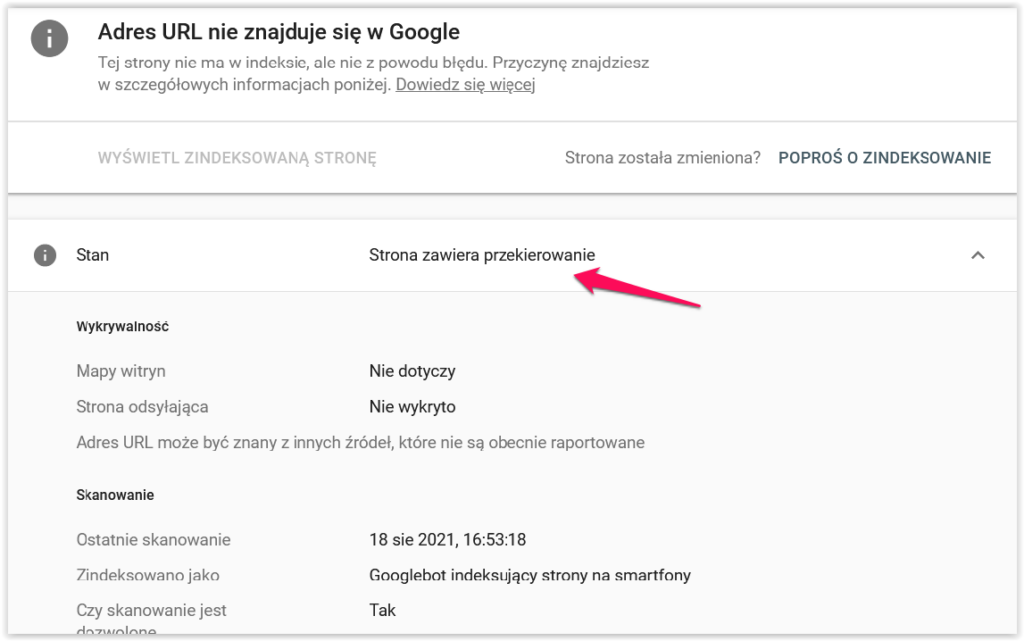
Jeśli adres przekierowuje na inny (kodem 301 lub 302), Google zindeksuje adres docelowy, a nie ten, który sprawdzasz. Podobnie działa tag canonical wskazujący inną stronę. W narzędziu do sprawdzania adresów URL zobaczysz, jaki adres Google uznał za kanoniczny.
Kody odpowiedzi serwera i ich wpływ na indeksowanie opisujemy w artykule SEO 101: kody odpowiedzi serwera, a zasady budowania jednego, kanonicznego adresu – w tekście adres URL a SEO.
Strona dostępna tylko po zalogowaniu
Robot Google nie loguje się na strony, więc treść ukryta za hasłem, w panelu klienta lub za paywallem bez odpowiednich oznaczeń nie trafi do indeksu. Zindeksowana może zostać co najwyżej strona logowania. Jeśli treść ma być w Google, musi być dostępna bez logowania.
Blokada w WordPressie
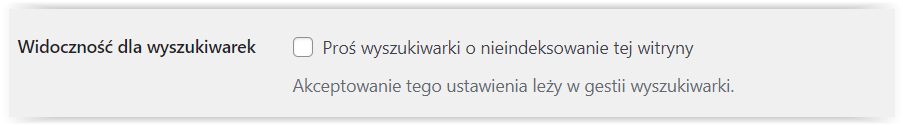
W WordPressie indeksowanie całej strony może wyłączyć jedno pole: Ustawienia → Czytanie → „Proś wyszukiwarki o nieindeksowanie tej witryny”. Opcja jest często zaznaczana na czas budowy serwisu. Jeśli strona ma być widoczna, upewnij się, że pole jest odznaczone, i sprawdź też ustawienia wtyczki SEO dla typów treści i taksonomii.
Problemy z serwerem i renderowaniem
Częste błędy 5xx, przekroczone limity hostingu lub bardzo wolne odpowiedzi sprawiają, że Google ogranicza skanowanie. Jeśli treść strony pojawia się dopiero po uruchomieniu JavaScriptu, sprawdź w narzędziu do sprawdzania adresów URL (zrzut ekranu i wyrenderowany HTML), czy Google ją widzi. Wpływ serwera na SEO opisujemy w artykule hosting a SEO.
Niska jakość lub duplikacja treści
Google nie indeksuje wszystkiego, co zna. Strony z bardzo krótką, powieloną lub automatycznie generowaną treścią – np. tysiące wariantów produktów z identycznym opisem albo strony lokalne różniące się tylko nazwą miasta – często dostają status „Strona zeskanowana, ale obecnie nie zindeksowana”. Rozwiązaniem jest rozbudowa treści, połączenie podobnych stron lub celowe wykluczenie mniej ważnych.
Co zrobić, gdy cała strona zniknęła z Google?
Gdy z wyników zniknął cały serwis, najpierw sprawdź w Search Console sekcję „Bezpieczeństwo i ręczne działania”. Ręczne działanie za spam lub informacja o włamaniu i złośliwym oprogramowaniu wyjaśniają większość takich przypadków.
Jeśli tam nic nie ma, sprawdź kolejno: plik robots.txt, tag noindex na stronie głównej i w szablonie, ustawienie widoczności w CMS, dostępność serwera i certyfikat SSL, przekierowania po ewentualnej migracji oraz to, czy domena nie wygasła. Na koniec porównaj datę spadku z historią aktualizacji Google. Pełną listę punktów kontrolnych znajdziesz w naszej checkliście SEO.
Jeśli mimo to nie znajdziesz przyczyny, warto zlecić audyt – problemy z indeksowaniem diagnozujemy w ramach usługi pozycjonowania stron.
Najczęstsze pytania
Ile trwa indeksowanie nowej strony w Google?
Od kilku godzin do kilku tygodni. Strony w serwisach często odwiedzanych przez robota i dobrze podlinkowane trafiają do indeksu szybko, a nowe domeny bez linków mogą czekać dłużej.
Czy prośba o zindeksowanie w Search Console gwarantuje indeksację?
Nie. Prośba przyspiesza ponowne skanowanie adresu, ale o tym, czy strona trafi do indeksu, decyduje Google na podstawie jej jakości i stanu technicznego. Wielokrotne zgłaszanie tego samego adresu nie zmieni decyzji.
Dlaczego strona była w Google, a teraz zniknęła?
Najczęściej z powodu zmian na stronie (noindex, przekierowanie, canonical, usunięcie treści), problemów z serwerem albo uznania jej za duplikat lub stronę niskiej jakości. Sprawdź adres w narzędziu do sprawdzania adresów URL i porównaj datę zniknięcia z ostatnimi zmianami w serwisie.
Czy niezindeksowane strony szkodzą całemu serwisowi?
Same w sobie nie, bo część adresów zawsze będzie poza indeksem. Problemem jest duża liczba słabych lub zduplikowanych stron, które marnują zasoby robota i mogą obniżać ocenę jakości całej witryny.
Czy strona może być widoczna w odpowiedziach AI, jeśli nie jest zindeksowana?
W przypadku AI Overviews i AI Mode – nie, Google wymaga, by strona była zindeksowana i mogła wyświetlać fragment w wynikach. Inne czaty AI korzystają z własnych robotów i indeksów, więc ich dostęp zależy od tego, czy nie blokujesz ich w robots.txt.